B300 和 H200 怎么选,一句话结论:显存预算内、机房供电跟得上、追新推理精度,选 B300;预算更稳、想快速上线跑大模型推理,选 H200。两款都是 8 卡整机的成熟方案,区别不在"谁更强",而在你的场景、机房条件和采购节奏。下面这份决策表,是我们根据 2026 年实际交付的几十套 8 卡整机经验整理的,按顺序过一遍,5 分钟能定方向。
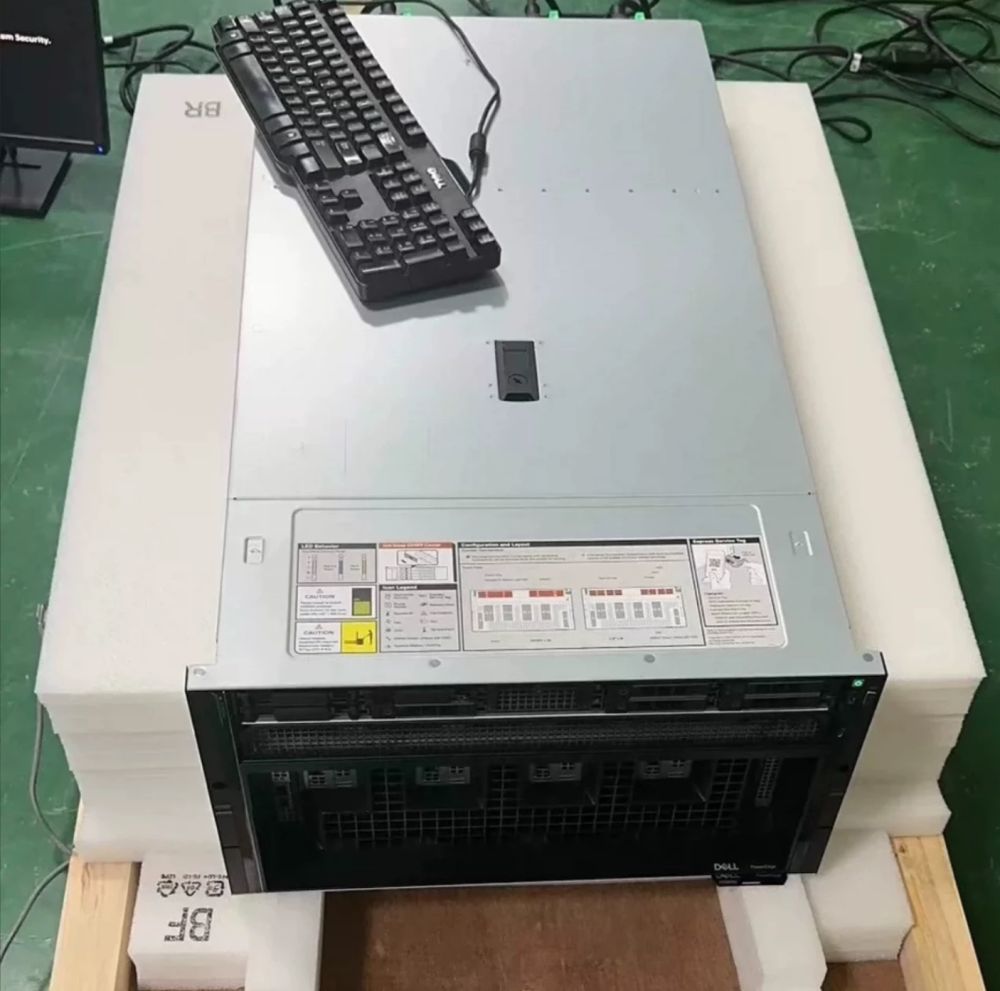
图:8 卡 GPU 服务器整机正面(AI 生成示意图,实拍图可询价索取)
一、先说判断标准:8 卡 GPU 整机到底比什么
不管买 B300 还是 H200,采购前建议把这 6 件事想清楚——这是所有 GPU 服务器选型的通用标尺:
- 单卡显存容量与带宽:决定能跑多大的模型、推理并发能开多高;
- 支持的精度:FP8 是现在的主流,FP4 是新一代低精度推理的方向;
- 单机功耗与机房条件:8 卡整机的 GPU 部分功耗差距很大,直接决定要不要改机柜、换配电;
- 预算与交付周期:新平台首发阶段溢价明显,上一代平台价格更稳;
- 保修与备件:GPU 整机不是买完就结束,出卡、出主板时要看有没有备件和上门维保能力;
- 软件生态成熟度:驱动、CUDA 版本、框架适配,越成熟的平台踩坑越少。
这 6 条里,第 1、2 条决定"能不能干这活",第 3 条决定"机房装不装得下",第 4-6 条决定"买回来用着省不省心"。
二、B300 vs H200:核心参数对比
按上面的标准,把两款平台放在一起看:
| 对比项 | 8 卡 H200 整机 | 8 卡 B300 整机 |
| 单卡显存 | 141GB HBM3e | 288GB HBM3e |
| 整机 GPU 功耗 | 约 700W × 8 ≈ 5.6kW | 约 1400W × 8 ≈ 11kW 级 |
| 精度支持 | FP8 / FP16 | FP4 / FP8(原生 FP4 推理) |
| 平台成熟度 | 量产两年以上,生态成熟 | 2026 年量产爬坡,生态快速完善 |
| 擅长场景 | 大参数模型推理、微调 | FP4 高并发推理、大模型训练、长上下文 |
| 价格与交付 | 价格趋稳、备货充足 | 首发期价格波动大、交付周期长 |
| 机房要求 | 常规风冷机柜基本可承载 | 需核算供电与散热,可能涉及机柜改造 |
两个直观的差异:
显存翻倍:H200 单卡 141GB,B300 直接给到 288GB。跑 70B、180B 级别的大模型做推理,H200 一张卡能放下 70B 的 FP8 权重还有余量;B300 则可以把更大模型、更长上下文装进单卡,减少跨卡通信。
 图:GPU 服务器内部的加速卡与散热鳍片(AI 生成示意图)
功耗翻倍:GPU 部分功耗从 5.6kW 级到 11kW 级,这不是"多插两根电"的事,机柜配电、UPS、散热都要重新算账(后面第四节专门讲)。
规格参数以英伟达官方发布为准,整机配置与报价以实际询价为准。如果你想先弄清两个平台的技术细节,可以看我们整理的 FAQ:B300 与 H200 常见问题解答。
三、分场景推荐:训练、推理、混合怎么配
场景一:主要跑大模型推理(客服、知识库、代码助手这类)
如果模型在 70B 级、并发要求中等,8 卡 H200 整机是目前性价比和交付速度都更稳的选择:显存够用、生态成熟、机房不用大改。如果追求单卡更大显存、FP4 推理降本,或模型已到 180B/600B 级别,B300 的 288GB 显存优势就体现出来了。
场景二:要训练或大规模微调
训练对显存、带宽和互联的要求都更高,建议直接上 8 卡 B300 平台,一步到位。训练集群的组网(IB 交换机、光模块、线缆)是另一门学问,可以参考我们的集群组网文章,或直接让工程师按你的模型规模出组网清单。
场景三:推理为主、偶尔训练
这种情况不必为"偶尔"多付一倍功耗成本,H200 为主、按需扩 B300 是更务实的路径。
落地建议:我们在深圳备有 B300、H200 两代平台的 8 卡整机与备件,机器上架前可以按你的模型清单先做一轮显存和功耗核算,避免"买回来装不下"或"显存不够再追加"。整机配置与在库情况见 B300 8 卡 GPU 服务器产品页。
四、采购操作步骤:从选型到上架的 5 步
确定了方向,实际采购按这 5 步走,每一步都有明确的交付物:
- 定场景清单:列出要跑的模型、量化精度、并发目标、上线时间。这一步的产出是一份"负载清单",是后面所有决策的输入;
- 机房核算:按 8 卡整机 GPU 功耗 + CPU/内存/网络约 2-3kW 余量,核算机柜配电(单机 220V/32A 还是 63A)、UPS 容量与散热上限。B300 平台如果机柜是老标准,通常要动配电;
- 确认配置单:CPU、内存、NVMe、网卡(IB 还是 RoCE)逐项定,避免"整机默认配置"和你的业务错配;
- 上架前验机:到货后做 72 小时压测——GPU 满载拷机、显存扫描、NVLink 拓扑校验、驱动与固件版本核对,问题在保修期内暴露;
- 签保修与维保:确认保修年限、备件库位置、上门响应时间。GPU 整机的维保和普通服务器不是一回事,最好在合同里写明 SLA。
 图:上架前的验机与巡检(AI 生成示意图)
第 2、4、5 步如果自己机房没有把握,可以直接交给服务方做:我们提供机房电力散热核算、上架验机和后续维保服务,具体服务内容见 服务器维保与运维服务。
五、电源与机柜改造:B300 上架前必须算的三笔账
选 B300 的团队,大概率绕不开机柜改造,先把账算清楚:
配电账:单机 GPU 11kW 级 + 主机其他部件约 2-3kW,按 80% 负载率反推,单机需要 63A/220V 级别的供电;一柜两机就是 26kW 级,老机房的单柜 10-15kW 标准明显不够。
 图:数据中心机柜与冷热通道(AI 生成示意图)
散热账:11kW 级 GPU 风冷仍在可行范围,但要求机柜风道封闭(冷热通道隔离)+ 机房精密空调有余量;如果还要叠加 NVL72 这类整机柜方案,就要评估液冷了。
余量账:UPS 和市电都要留 30% 以上余量,GPU 满载训推切换时的功率波动比传统服务器大得多。
这三笔账算完,很多团队会发现:改造费加上首发溢价,B300 的综合落地成本比参数表上看的要高出一截——这也是"场景一"里我们建议纯推理用户优先 H200 的原因。核算拿不准的话,把机房参数发给我们,工程师帮你出一份电力散热评估。
六、交付周期与最后决策
2026 年的交付现状:8 卡 H200 整机供需已趋稳,常规配置备货充足(以当日库存为准),上架后一周内可完成部署;8 卡 B300 整机仍处产能爬坡期,交付周期以实际排产为准,热门配置建议提前沟通锁定。
最后给一张速查表:
| 你的情况 | 建议 |
| 70B 级推理、预算敏感、要快速上线 | 8 卡 H200 |
| 180B+ 大模型、FP4 推理、训练/微调为主 | 8 卡 B300 |
| 推理为主偶尔训练 | H200 为主,按需扩 B300 |
| 老机房、配电没把握 | 先做电力核算,再定平台 |
方向定了之后,下一步就是把模型清单和机房参数发过来,我们按实际负载出整机配置单和报价。可以直接在在线询价页提交需求,也可以电话联系,深圳本地备有整机与备件,工程师当天就能给你反馈配置方案。
需要针对你的设备与场景做一次评估?
把设备型号、故障现象或采购清单发给我们,工程师会按你的实际情况给方案,而不是套模板。
- 7×24 故障接收与响应,远程先定位再决定是否到场
- 备件先行,铂金档 4 小时到场,同城/省内当日达
- 维修部件质保 1 年起,可按合同延长